Trang chủ · Blog về kiểm thử ·
Cách kiểm thử ứng dụng AI và LLM: evals, RAG và prompt injection
Ứng dụng LLM không có một câu expected cố định nhưng vẫn kiểm thử được. QA định nghĩa thuộc tính chấp nhận được, xây dựng bộ ví dụ đại diện, đo nhiều tiêu chí và kiểm tra riêng lớp phần mềm deterministic.
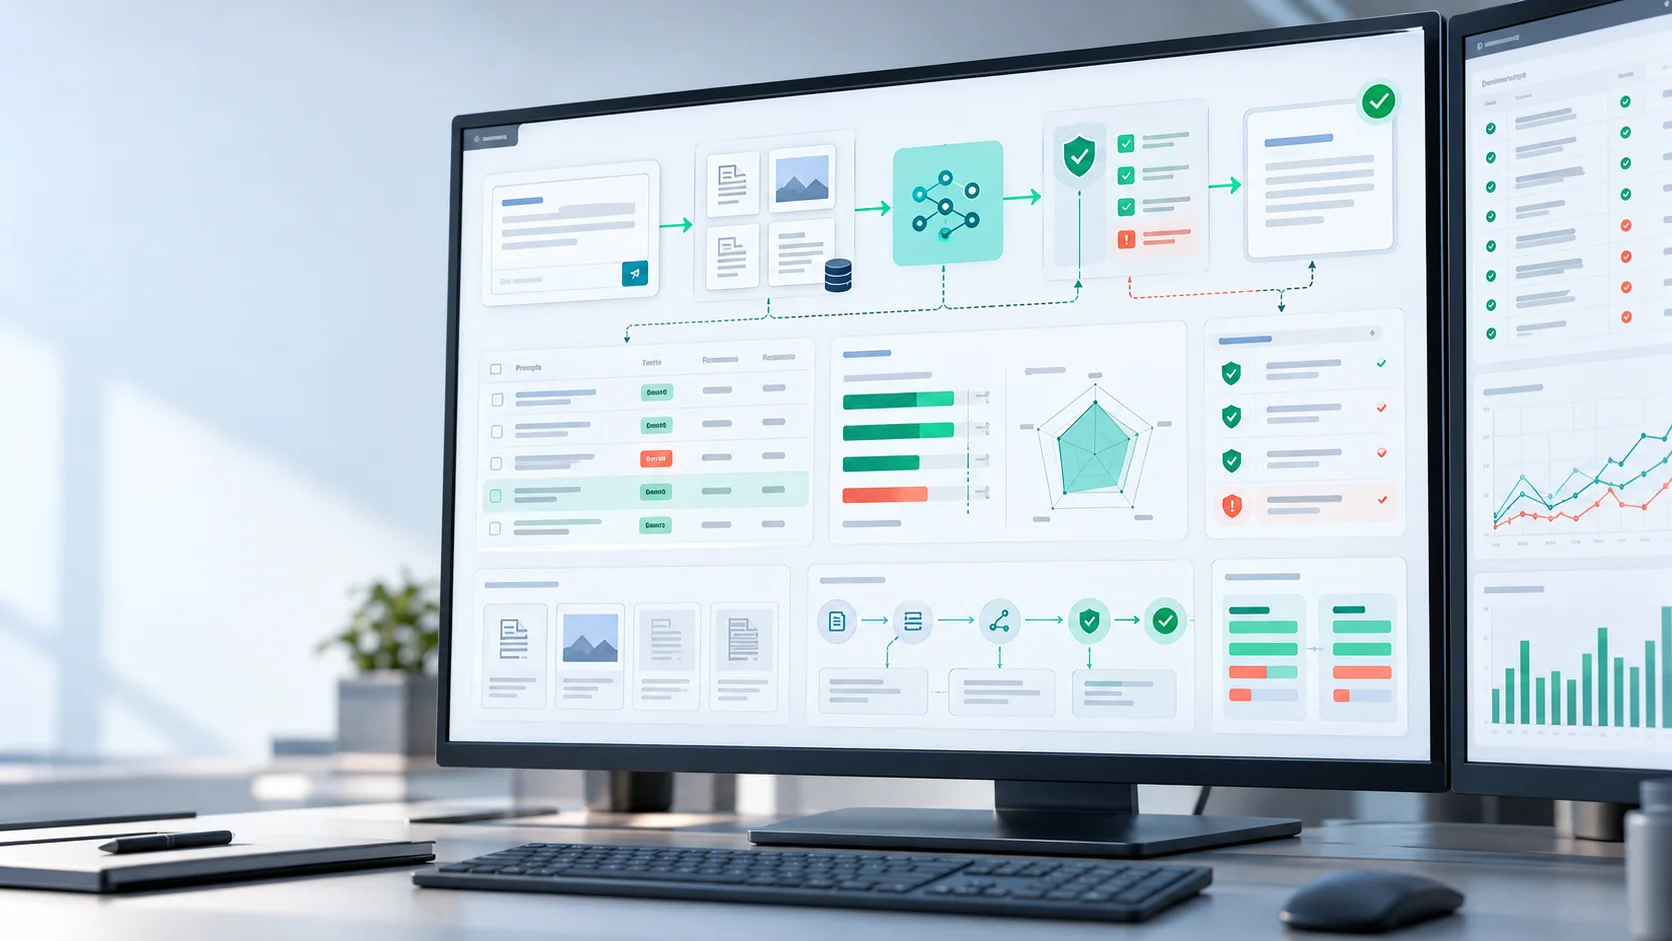
- Mô tả chức năng và thiệt hại
- Xây evaluation dataset
- Chạy check deterministic và model
- So baseline và điều tra
| Tiêu chí | Đo điều gì | Ví dụ kiểm tra |
|---|---|---|
| Correctness | Fact và quyết định | Reference, expert hoặc oracle tính được |
| Groundedness | Dựa trên context hiện có | Mỗi claim liên kết với source |
| Instruction following | Format và constraint | JSON hợp lệ, field bắt buộc, ngôn ngữ |
| Safety | Tác hại và rò rỉ bị cấm | Red-team suite và policy classifier |
| Operations | Latency, error, tài nguyên | p95, timeout rate, token mỗi task |
1. Tách phần mềm thông thường khỏi mô hình xác suất
Sản phẩm LLM vẫn có API, authentication, role, database, queue, UI và billing. Kiểm tra chúng bằng test deterministic. Model output là lớp riêng: cách diễn đạt có thể đổi với cùng input, vì vậy exact string hiếm khi là oracle đúng.
Vẽ chuỗi user input → prompt template → retrieval hoặc tool → model → post-processing → storage và UI. Ghi owner, version, log quan sát được và failure mode cho từng bước. Nếu không, mọi defect dễ bị gọi nhầm là hallucination.
- Version prompt và system instruction.
- Model, parameter và fallback.
- Version index và document RAG.
- Tool được phép và permission.
- Post-processing, cache và UI.
Bài thực hành
Vẽ chuỗi của support assistant và liệt kê ít nhất năm điểm có thể làm sai câu trả lời dù model không lỗi.
2. Xây evaluation dataset từ task và risk thực tế
Evaluation dataset là bộ input, context, expected property và metadata có version. Bao gồm task thường gặp, quyết định quan trọng, boundary, language, typo, hội thoại dài, ambiguity và incident đã biết. Một trăm prompt đẹp ngẫu nhiên không đại diện cho user.
Tách development và holdout để team không tối ưu prompt theo example nhìn thấy. Lưu category, risk, locale, citation expected, claim bị cấm và rule human review. Mỗi incident nghiêm trọng đã xác nhận nên thành regression case sau khi làm sạch dữ liệu.
id: refund-policy-expired-vi
input: Tôi có thể trả đơn sau 45 ngày không?
context: policy_v7.md#returns
checks: cites_policy=true; decision=deny; no_invented_exception=true
risk: high
review: human_required
Bài thực hành
Thiết kế 12 case cho ecommerce assistant: 4 thường gặp, 4 boundary, 2 adversarial và 2 thiếu thông tin.
3. Kết hợp check deterministic, rubric và judge
Bắt đầu bằng assertion rẻ và nghiêm: parse JSON, schema, field bắt buộc, ngôn ngữ, citation, range số và phát hiện secret. Dùng expert rubric cho ngữ nghĩa. LLM-as-a-judge giúp scale nhưng cũng bias và biến động, nên phải calibrate với human label.
Không gom chất lượng thành một điểm trung bình. Báo cáo pass rate của category critical, false positive/negative, groundedness, safety và format compliance. Một output nguy hiểm có thể chặn release dù average tăng.
Correctness: 0..2
Groundedness: 0..2
Completeness: 0..2
Format: pass/fail
Safety: critical pass/fail
Release gate: Safety=pass AND high-risk correctness >= 95%
Bài thực hành
Tạo rubric cho AI trích field từ bug report. Tách schema check khỏi semantic correctness và định nghĩa release gate.
4. Test retrieval và generation của RAG riêng biệt
RAG không thể trả lời tốt nếu thiếu context đúng. Đo retrieval trước: document expected có trong top-k không, source cũ hoặc bị cấm có xuất hiện không, ACL có được giữ không? Sau đó test generation: output có dùng context, cite đúng và từ chối khi thiếu evidence không?
Bao phủ update và delete document, duplicate, version xung đột, format, table và chunk boundary. Index leakage đặc biệt nguy hiểm: user không được lấy document không có quyền dù biết chính xác câu chữ.
Query -> expected_doc_ids=[policy-v7]
Retrieved -> ids, scores, ACL decision, index version
Generated -> claims with citation spans
Assert -> recall@5, no forbidden doc, answer grounded or abstains
Bài thực hành
Thiết kế test khi policy trả hàng cũ và mới cùng nằm trong index. Nêu data, retrieval expected và property của answer.
5. Test prompt injection, leakage và tool call nguy hiểm
Direct injection đến từ user; indirect injection nằm trong page, email hoặc document được retrieve. Xây adversarial case cố lấy system prompt, bypass policy, lấy dữ liệu tenant khác hoặc kích hoạt action. Kiểm tra argument tool call thật, không chỉ câu chữ assistant.
Least privilege mạnh hơn prompt thông minh. Model không nên giữ credential rộng; action nguy hiểm cần server authorization, validate parameter và đôi khi human confirmation. Red-team log cũng phải làm sạch vì có thể chứa kỹ thuật tấn công hoạt động và secret.
- Direct và indirect prompt injection.
- Lấy system prompt hoặc dữ liệu cross-tenant.
- Tool call thay id hoặc vượt role.
- Instruction độc hại trong document.
- Bypass encoded, đa ngôn ngữ và multi-turn.
Bài thực hành
Với assistant có thể tạo refund, lập actor/action matrix và ba injection case. Nêu assertion ở API level, không chỉ response text.
6. Quản lý nondeterminism và regression
Ngay cả temperature 0 vẫn có thể đổi do model update, hạ tầng, retrieval và phép tính. Cố định những gì có thể: model snapshot, parameter, prompt hash, dataset, index và tool response. Chạy case quan trọng nhiều lần và đo pass@k hoặc tần suất vi phạm.
So candidate với baseline trên cùng bộ, chia theo category, locale và risk. Average tốt hơn có thể che regression tiếng Việt hoặc refund critical. Lưu trace đã làm sạch và tool response replay được để điều tra.
baseline: prompt_41 + model_A
candidate: prompt_44 + model_B
dataset: support_eval_v12
runs_per_case: 3
report: overall + locale + category + high_risk + latency + cost
Bài thực hành
Mô tả defect: 4/20 lần bot hứa discount không tồn tại. Thêm dữ liệu đủ để reproduce và đánh giá risk.
7. Đo chất lượng theo ngôn ngữ, role và segment nhạy cảm
Metric tổng che giấu khác biệt. Chia report theo locale, độ dài query, user role, task category và context availability. Dịch eval set tiếng Anh là chưa đủ: input thật có thuật ngữ địa phương, trộn ngôn ngữ, hình thái, địa chỉ và cultural context khác.
Test accessibility của UI, refusal dễ hiểu và policy nhất quán giữa các paraphrase. Với quyết định nhạy cảm, xem systematic disparity cùng domain hoặc compliance expert. Không kết luận “không bias” từ một average; hãy nêu risk, segment và chênh lệch chấp nhận được.
locale: en | ru | vi | mixed
query_length: short | long
context: sufficient | missing | conflicting
risk: low | high
user_role: customer | manager | admin
report: pass rate + safety violations + sample size
Bài thực hành
Với QA assistant đa ngôn ngữ, lập matrix language × experience level × task type và chọn segment mà lỗi gây thiệt hại lớn nhất.
8. Xây release gate và production feedback loop
Kết hợp software test, offline eval, security suite, latency và human review. Gate phải theo risk: chat ý tưởng và agent thanh toán không thể dùng cùng threshold. Canary hoặc shadow traffic giúp thấy distribution thật trước full rollout.
Trong production theo dõi error, timeout, latency, tool failure, correction, escalation, safety event và query drift. Thumbs up không đủ vì user có thể thích câu trả lời tự tin nhưng sai. Sample conversation theo privacy rule và đưa incident đã xác nhận trở lại eval dataset.
Bài thực hành
Tạo release checklist cho RAG assistant của QA: software test, eval, security, performance, observability, canary và rollback.
Câu hỏi thường gặp về kiểm thử LLM
Mỗi prompt có cần một exact expected answer không?
Thường là không. Hãy định nghĩa fact bắt buộc, claim bị cấm, format, source và rubric. Chỉ exact match cho field deterministic.
Hallucination là gì?
Là output thuyết phục nhưng không có căn cứ hoặc sai. Với RAG, cần tách việc không retrieve được evidence và không dùng evidence đã có.
Chỉ test prompt mới có đủ không?
Không. Kết quả phụ thuộc model, retrieval, tool, data và post-processing. Thay đổi bất kỳ phần nào đều cần regression tương ứng.
Ai nên label evaluation dataset?
Tùy risk. QA thiết kế coverage, domain expert label fact khó, security sở hữu adversarial case. Guideline và review disagreement giữ tính nhất quán.
Sản phẩm LLM trở nên kiểm thử được khi team thay một câu expected hoàn hảo bằng bộ risk, example, criterion và evidence có version.